大家好,我是鲁工。
大家在用Claude Code的时候,特别是在Plan mode下,经常会有借助于WebSearch工具来抓取网页数据的需求。但时常会碰到Fetch error的情况:
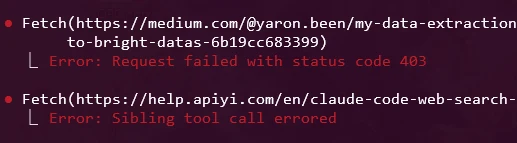
这其实是个老问题了。用Claude Code自带的WebFetch和WebSearch工具,查资料、做调研,80%的场景下够用,但一碰到JS渲染的页面、需要登录的站点、或者大规模数据采集的需求,内置工具就顶不住了。
前两天,看到Santiago(@svpino,AI/ML领域的知名博主)分享了一套方案,他说可以用Claude Code从任何网站拉取实时的结构化数据,返回的是可以直接用的表格,不是那种一大段文字摘要。我试了一手,确实很好用。
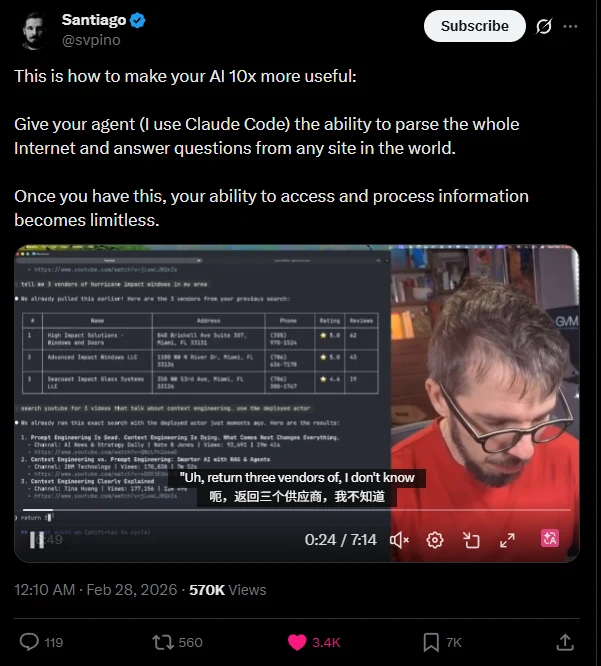
今天就来聊聊怎么给Claude Code装上全网数据采集能力,两条路径,按需选择。
Claude Code内置联网工具的短板
Claude Code自带两个联网工具:WebSearch负责搜索,WebFetch负责抓取页面内容。
WebSearch比较简单,你给它一个搜索词,它返回相关链接和标题。WebFetch稍微复杂一点,你给它一个URL和一个问题,它会抓取页面内容,通过Turndown库把HTML转成Markdown,截断到100KB以内,再用一个轻量模型(Haiku)帮你总结。
说白了,这两个工具就是个简易版的浏览器。能用,但有几个硬伤。
最大的问题是不能渲染JS。现在大量网站是SPA(单页应用),内容靠JS动态加载。X/Twitter、很多电商平台、各种SaaS后台,WebFetch都抓不到实际内容,只能拿到一个空壳。
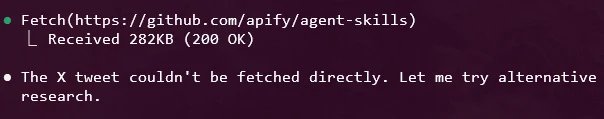
反爬能力也基本为零。不支持代理轮转,不能处理CAPTCHA验证码,碰到有反爬机制的网站就只能开摆。
还有一个痛点是只返回文本摘要。如果你想拿到结构化的数据(比如商品价格表、用户评论列表、竞品功能对比),WebFetch做不到,它给你的永远是一段经过压缩的文字。
这三个短板加在一起,让Claude Code在数据采集这件事上始终缺乏易用性。但现在有了解决方案。
方法一:Apify Agent Skills
Apify是一个老牌的云端爬虫平台,做网页抓取和自动化很多年了。最近他们推出了一套Agent Skills,简单来说就是一组预制的技能包,专门教AI Coding Agent怎么做数据采集。
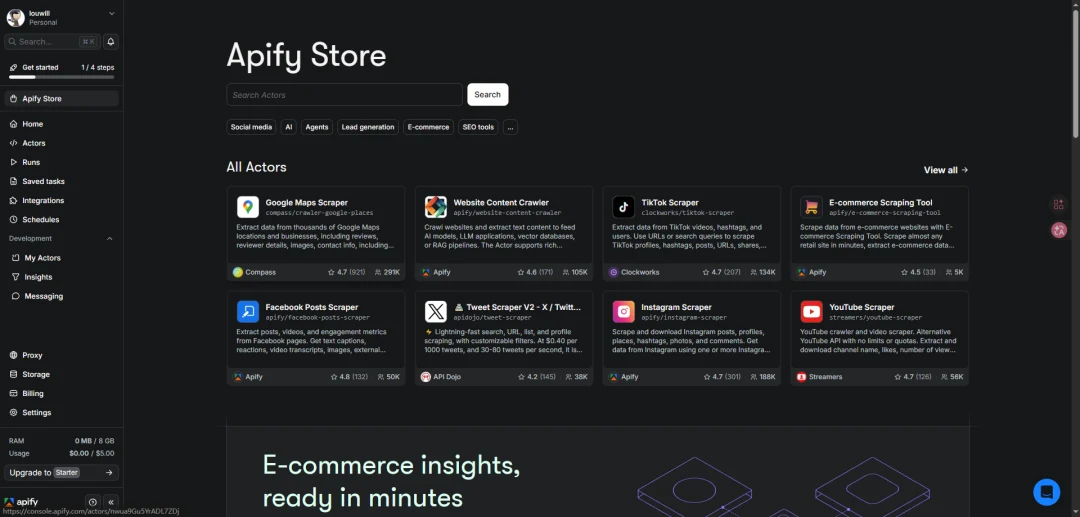
GitHub仓库地址:
https://github.com/apify/agent-skills
这套Skills支持Claude Code、Cursor、Codex、Gemini CLI等主流AI编程工具。目前一共有12个技能,覆盖面相当广。
核心的apify-ultimate-scraper是一个万能爬虫技能,可以抓取Instagram、Facebook、TikTok、YouTube、Google Maps、Google Search等平台的数据。关键是它返回的是结构化数据,可以直接导出CSV或JSON,拿来就能用。
其他技能覆盖了竞品分析、品牌口碑监测、电商数据采集、KOL发现、潜客获取、趋势分析等场景。如果你做市场调研或者商业数据分析,这一套简直是神奇。
在Claude Code里安装这套Skills也很方便。前提是需要一个Apify账号(去apify.com注册,有免费额度),拿到API Token后就可以开始配置。
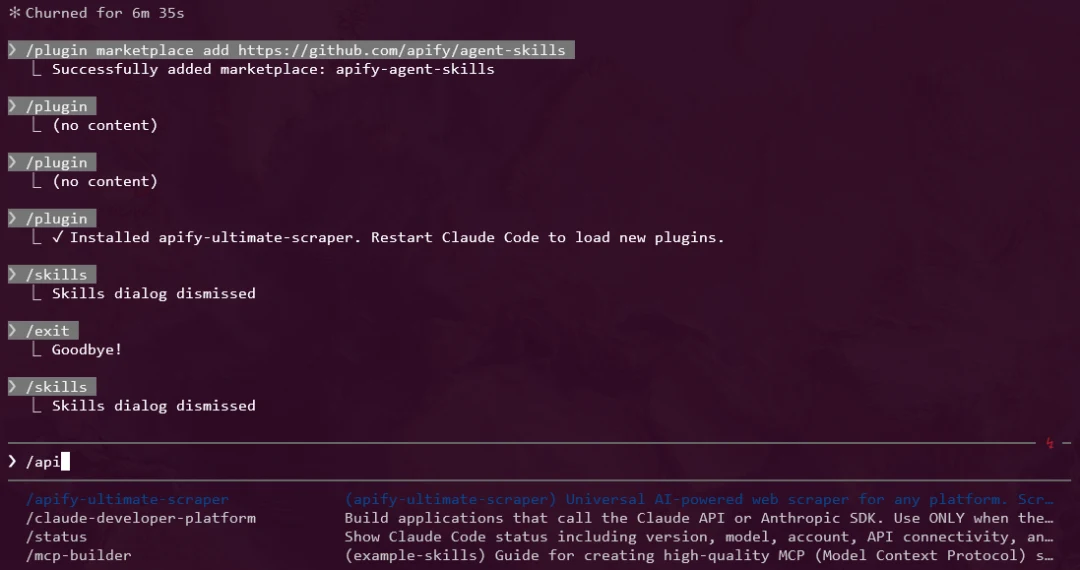
安装分两步。先添加市场源:
/plugin marketplace add https://github.com/apify/agent-skills
再安装你需要的技能,比如万能爬虫:
/plugin install apify-ultimate-scraper@apify-agent-skills
也可以用通用的npx方式一次装完所有技能:
npx skills add apify/agent-skills
安装后别忘了在项目根目录的 .env 文件里配上你的API Token:
APIFY_TOKEN=你的token
比如抓取Youtube视频数据:
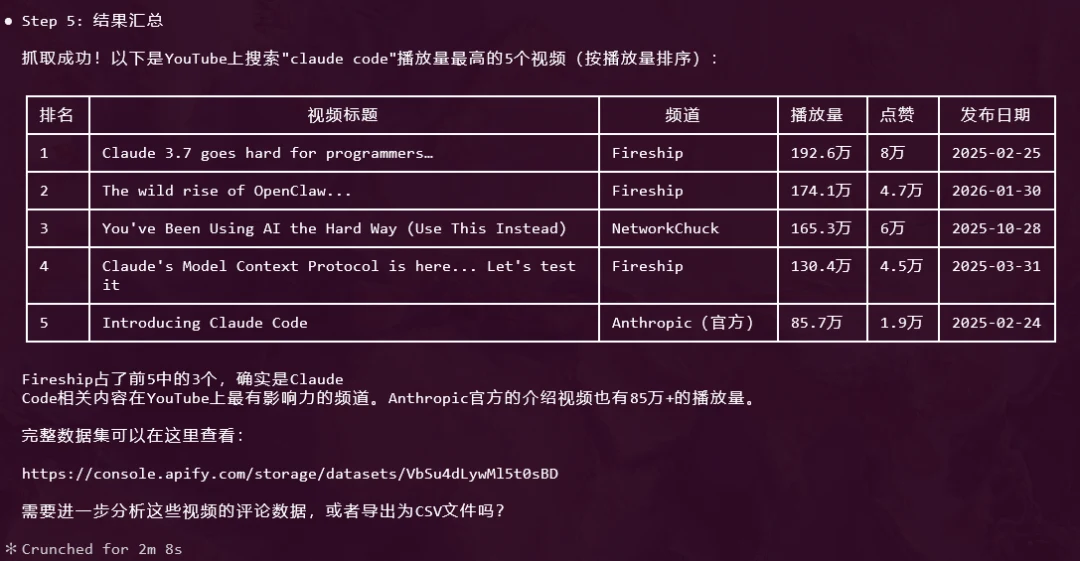
这里说个关键点。Santiago在推文里反复强调,这个方案的核心优势是返回结构化数据。比如你让Claude Code帮你抓取某个电商平台的商品列表,拿到的是整理好的表格(品名、价格、评分、链接),可以直接拿来做分析,比WebFetch返回的文字摘要实用太多了。
Apify的计费模式是按结果付费,也就是说只有成功抓到数据才扣钱。不过对个人用户来说,免费额度够做不少事了。
方法二:Apify MCP Server
如果你想要更灵活的控制,或者Skills里没有覆盖到你的场景,还有第二条路:直接通过MCP(Model Context Protocol)接入Apify平台。
通过Apify MCP Server,Claude Code可以直接调用Apify Store里数千个现成的爬虫和自动化工具。
GitHub仓库地址:
https://github.com/apify/apify-mcp-server
MCP方案配置也不复杂。推荐用托管的远程服务器方式,配置最省事。在你的MCP配置文件里加上:
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com",
      "headers": {
        "Authorization": "Bearer 你的APIFY_TOKEN"
      }
    }
  }
}
如果你更喜欢本地运行,可以用Stdio方式:
{
  "mcpServers": {
    "apify-mcp": {
      "command": "npx",
      "args": [
        "-y",
        "@apify/actors-mcp-server"
      ],
      "env": {
        "APIFY_TOKEN": "你的APIFY_TOKEN"
      }
    }
  }
}
配好之后,Claude Code就能调用search-actors(搜索可用的爬虫)、call-actor(执行爬虫任务)、get-dataset-items(获取抓取结果)等工具了。
Skills和MCP方法可以都安装下,二者本身可以互补。
如果你的需求是高频的、场景固定的(比如每天抓一次竞品价格),用Skills更省心,预制的工作流开箱即用。
如果你的需求是临时的、场景多变的(今天抓社交媒体,明天抓政府公开数据),用MCP更灵活,Apify Store里有15000+的Actor可以随时调用。
两种方式前提都一样:需要Apify账号和API Token,需要Node.js 20.6+环境。
一定要注意一个时间节点:Apify MCP Server的SSE传输方式将在2026年4月1日废弃,届时需要更新为Streamable HTTP方式。如果你是现在开始配置,直接用上面推荐的配置就好,已经是新方式了。
其他值得关注的方案
Apify之外,还有几个MCP搜索方案值得了解。
Brave Search MCP是Anthropic官方推荐的搜索方案,每月2000次免费查询,适合日常搜索补充,但它只是搜索引擎,不能做结构化数据采集。
Playwright MCP可以做真正的浏览器渲染,能处理JavaScript动态页面,适合那些WebFetch搞不定的JS重度站点。但它更偏向自动化操作,不如Apify方便做大规模数据采集。
Bright Data MCP走的是企业级路线,支持代理轮转和CAPTCHA处理,2026年新推了一个免费档(每月5000次MCP请求),适合需要突破反爬机制的场景。
这几个方案各有侧重,可以按需搭配。我现在的组合是内置WebFetch/WebSearch处理日常查资料的需求,Apify Skills处理结构化数据采集。
Claude Code的联网能力,内置工具能覆盖日常80%的场景,但那剩下的20%(JS渲染、反爬、结构化数据)恰恰是很多实际工作中绕不开的。Apify的Agent Skills和MCP Server把这个缺口补上了,配置过程也不复杂,非常推荐有数据采集需求的同学试试。
本文首发于微信公众号「AI编程实验室」,阅读原文