大家好,我是鲁工。
DeepSeek官方Harness工具,DeepSeek Harness(dsh)发布一个多月了,但我一直没怎么用。
直到上周,我的Codex额度没把控好,加上Tibo上周一整周都没重置,所以我上周才有机会深度用dsh。之前发布的时候,咱们号写过一篇资讯短文,今天就最近一段时间的使用体感,来聊一把dsh。
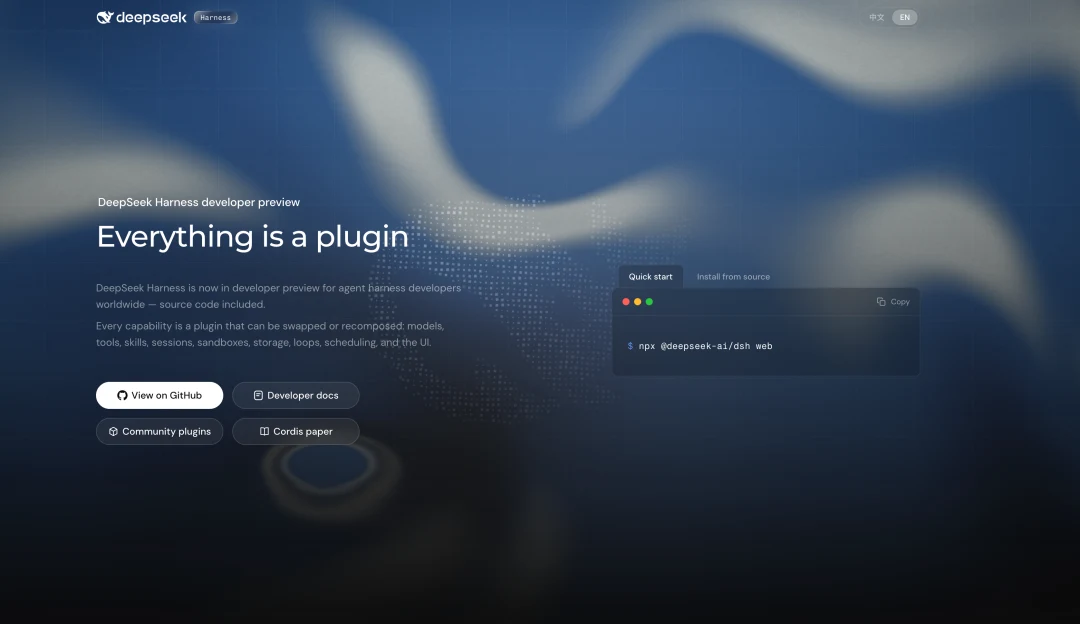
插件组成的 Harness
先简单回顾下dsh吧。之前官方定位和宣传,总是强调一切皆插件,这次展开讲讲。架构文档里有句话写得好,叫做"不存在需要打补丁的特权内核"。熟悉Claude Code的朋友,对MCP、Slash Commands、Skills、Subagents、Plugins、Dynamic workflow、Agent Teams这些机制都不陌生,到了dsh里这些功能其实大部分也都有,只是全部拆成了插件。
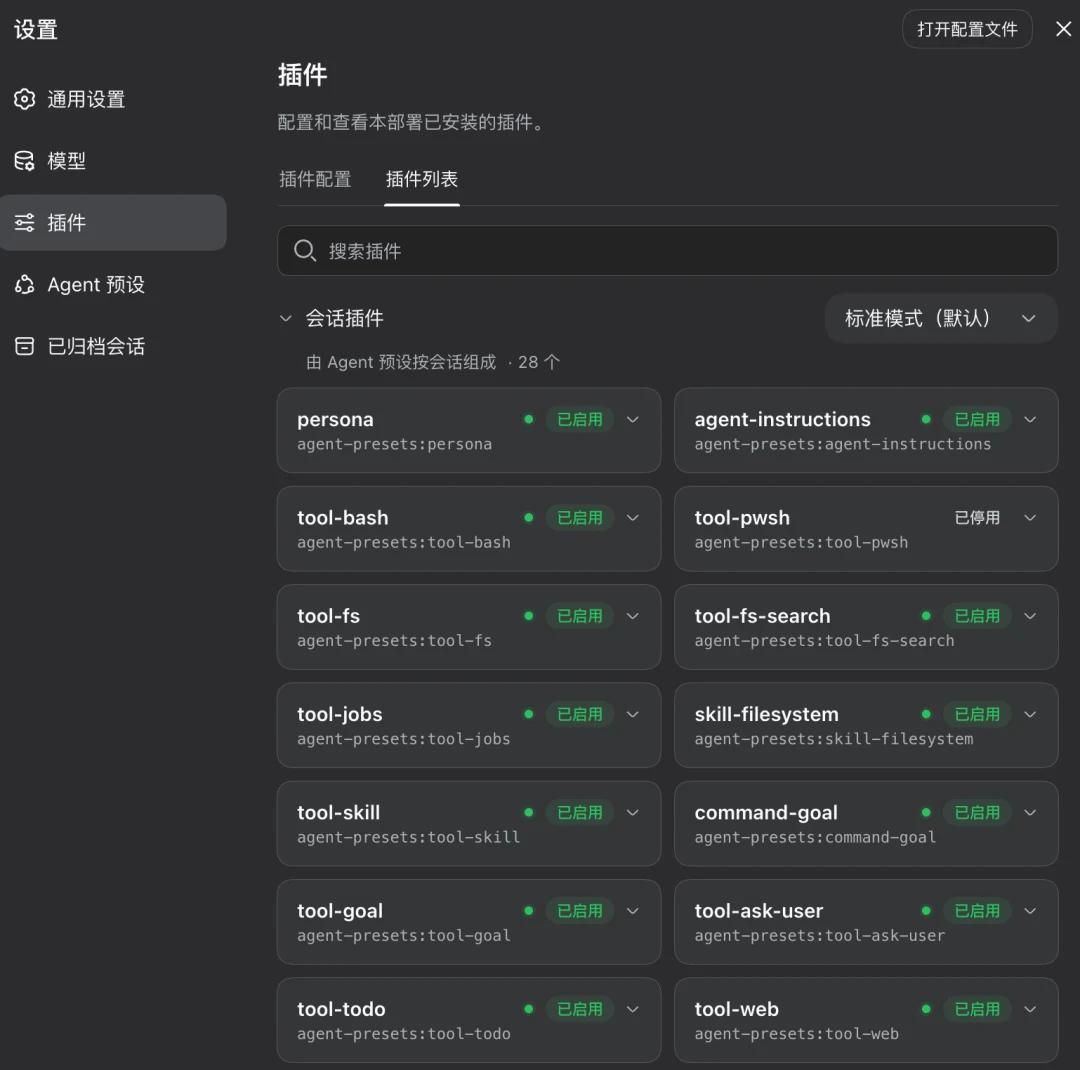
跑一条命令,默认的Web配置装了哪些插件会全部打印出来。dsh没有全局命令,用npx跑就行,顺手把DSH_HOME指到一个临时目录,免得动到你平时那套配置:
DSH_HOME=$(mktemp -d) npx @deepseek-ai/dsh --profile web --dump-config
npm上的0.1.5-rc.2打印出来一共152个插件条目,84个来自基础层,68个来自Web应用层,其中45个是界面组件。驱动模型一轮轮调用工具的那个主循环,也只是其中一行,id叫agent-loop。打印出来的任何一项,都能在自己的覆盖配置里替换或关掉,不用改一行源码。
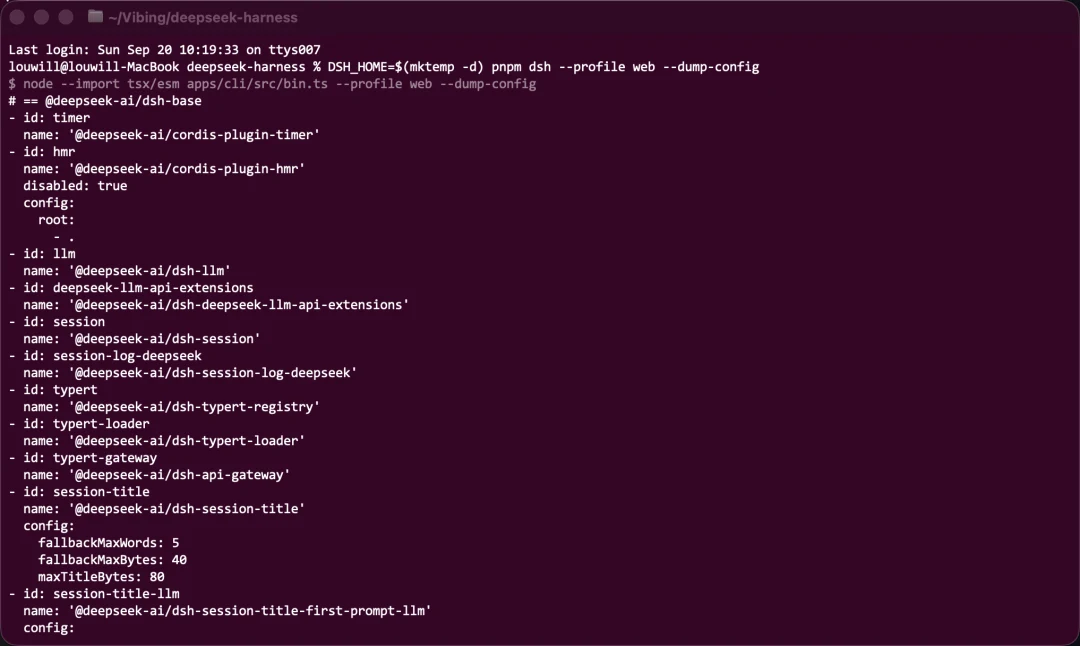
咱们对照Claude Code看,大致是这样:
| Claude Code里的机制 | dsh里对应的插件 |
|---|---|
| MCP | mcp-client(一台服务器配一个)、mcp-resources |
| 斜杠命令 | commands服务,具体命令由各功能插件自己注册,/compact、/goal、/plan分别来自command-compact、command-goal、plan-mode |
| Skills | skill注册表、skill-filesystem(扫描 .dsh/skills 和 .agents/skills,不扫 .claude/skills)、tool-skill |
| Subagents | subagent服务,加上进程内新建、带历史分叉、ACP、Codex、Claude Code、另一个dsh六种后端,再加两个工具插件 |
| Hooks | 插件直接监听agent和工具事件;hooks-claude-code能直接跑现成的hooks.json(只支持command类型) |
| Plugins | 插件本身就是npm包,dsh plugin命令转给pnpm安装 |
| Dynamic workflows | workflow服务、workflow-ptc执行引擎、tool-workflow,另有默认关闭的ralph |
| Agent Teams | 实验性的agent-team服务、工具和界面插件,默认不挂 |
在Claude Code里面,这些机制是Anthropic做好的功能,留给用户的是往里填内容:往.claude目录放md,在settings.json写hooks,在.mcp.json配置服务器,plugin也只是把这些内容打成一个包。机制本身怎么运转,比如agent loop怎么跑、subagent怎么调度,无需用户操心。
dsh反其道而行之,机制本身就是插件,而且拆分得很细。以goal来说(给会话挂一个持久目标,没完成就反复迭代逼近预设目标),这一个功能拆成了五个插件:dsh-goal负责记录目标,dsh-tool-goal给模型三个读写目标的工具,dsh-command-goal给用户一个/goal命令,dsh-goal-round-driver负责没完成就自动续跑,dsh-client-ui-goal管界面。如果不想让它自动续跑,关掉goal-round-driver这一个插件就行,其余照常工作。
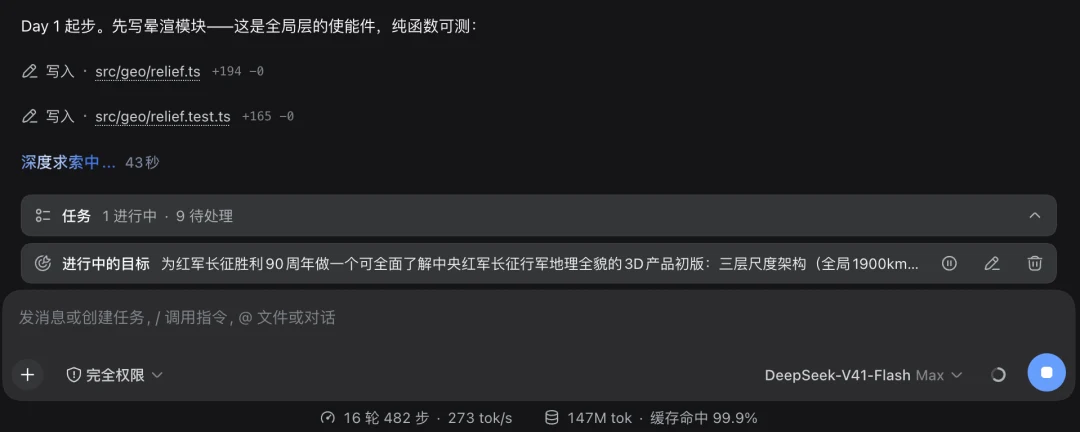
插件还分两层装配。上面那157个条目是进程层,管注册表、沙箱、持久化、模型路由和界面;每个会话挂哪些工具,由会话层的预设决定。官网说的四种模式,标准、Code、极简、创造,落到仓库里就是四个预设目录,标准模式那份有31个条目,极简模式只有7个。
再往深走就是创造模式。它给模型一组工具,让模型在运行中的dsh里现写一个插件,挂载、更新、卸载都能自己来,定义只放在内存里,重启就没了。也就是说,agent可以在运行时给自己的harness加插件。
插件系统用的是Cordis,一个2022年就开源的框架,做过QQ机器人的朋友可能听过的Koishi和它4000多个社区插件,之前就是架在Cordis上面的。
Web 形态与桌面端
dsh发布之后,我意外的一点,是dsh没有做CLI,而是在本机起一个node服务,再用浏览器打开Web页面来用。用惯了Claude Code等CLI模式的Agent,切换到dsh这种WebUI模式,多少有点不习惯。但一旦用起来,dsh的速度优势带来的丝滑体感会快速让你习惯这种模式。
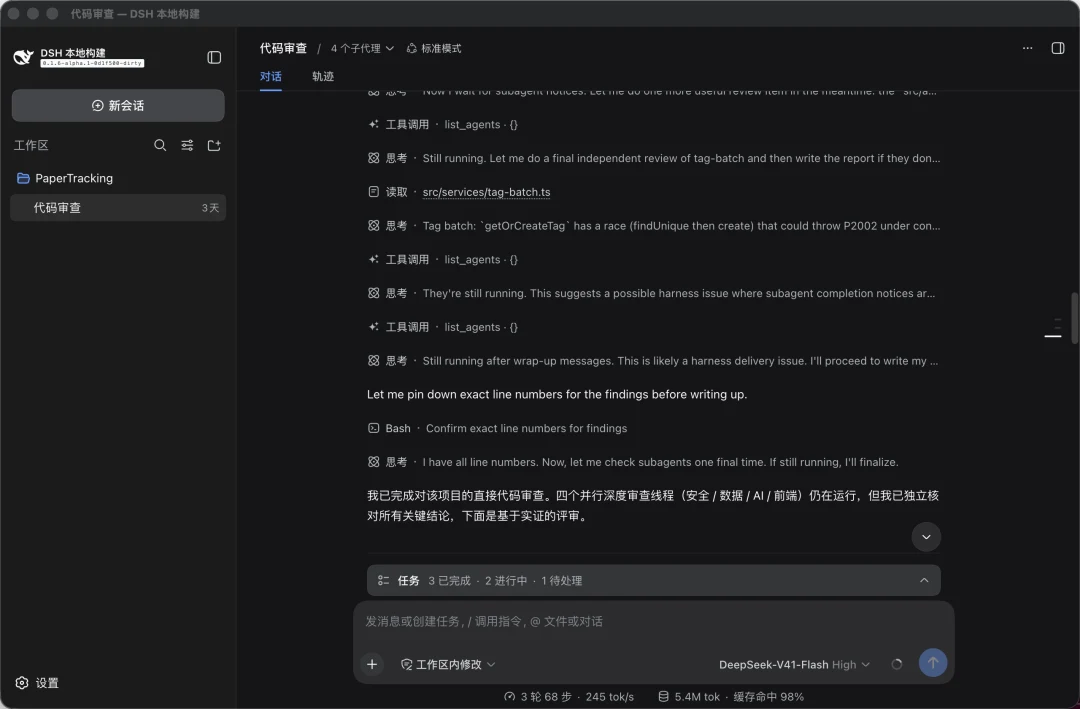
桌面端的情况有点微妙。官方的Electron桌面端其实已经在仓库里了,设计写得很讲究:不开任何Web端口,界面和后端之间走自定义的dsh-app://协议;自带一份Node.js和pnpm,不碰系统环境;桌面壳和dsh版本锁死,dsh每升一次级,桌面端就得跟着发一版。但到今天官方都没有正式发布,反倒是社区的anywhere-labs/dsh-desktop在dsh发布三个半小时后就上线了,现在也收割了不少star。
上下文日志与缓存
dsh的设计里,模型看到的一切,从系统提示词、思维链到工具结果和每一次上下文注入,全部写进一份只追加、不改写的会话日志,架构文档管这叫"模型可见即已记录"。Web里的Trajectory视图,就是按来源翻看这份日志。
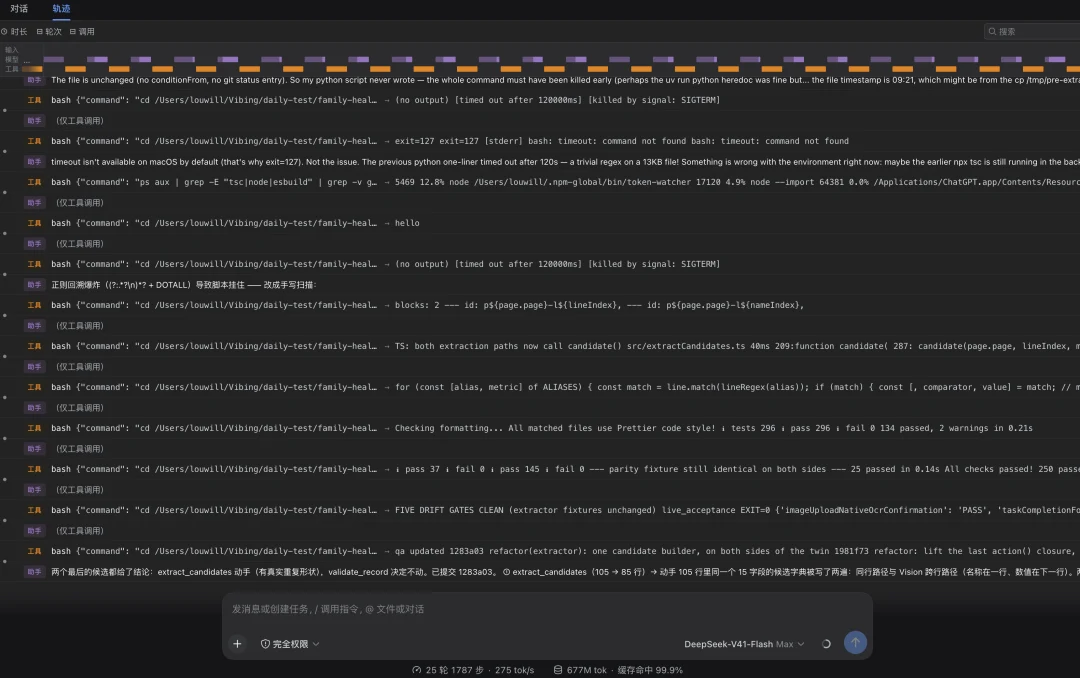
只追加的直接好处是缓存。大模型API的缓存按前缀计算,这次请求的开头和上次一模一样,那一段就按缓存价计费,DeepSeek现价只有未命中价的五十分之一。dsh连系统提示词更新都不去改开头,而是追加在已缓存的前缀后面,架构文档的原话是"具备能力的路由可在缓存前缀之后追加非空更新"。Prefill稳住了,上下文再长、Subagents再多,重复发送的那部分都按缓存价算。
dsh的负责人Tianyi Cui之前发推说:"新版本与DeepSeek V4.1 Flash模型训练深度结合,模型在DeepSeek Harness的不同配置中都进行了专项训练和优化。"
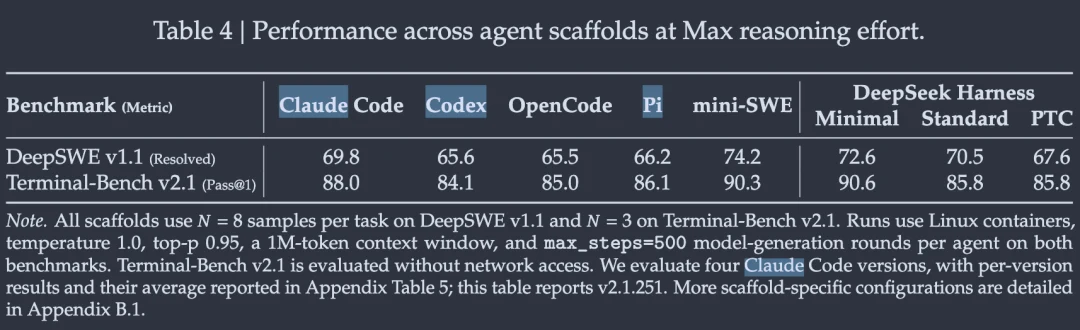
但V4.1-Flash技术报告里有张表可以参考下:同一个模型换不同的harness跑Terminal-Bench 2.1dsh极简模式90.6分,Claude Code 88.0,dsh标准模式85.8。自家功能最全的模式,分数排在Claude Code后面。报告的结论是模型能力能够在不同harness之间迁移得很好。
一周实测与 Token 消耗
设计聊完了,再说说这几天我是怎么用dsh的。
我上周用dsh跑了6个任务尝试,有的是Codex做剩下的现成项目,有的是我新开的项目。日志里的总共是77个会话,7174次模型请求,9957次工具调用,bash占了73%,一共20亿左右token,缓存命中率高达99.43%。
用下来最直接的感受就是速度极快,平均响应速度都在272 tok/s以上。用了几天下来之后,我在回到Codex和Claude Code,瞬间觉得低速难以忍受。但是速度快带来的后果就是非常费token,就像Codex和Claude开fast一样,dsh日常token消耗速度贼快。同一时段两边都在跑任务,DeepSeek后台的token计数远远超过Claude Code。我自己的Token Watcher面板上,9月16号dsh用了7.15亿,Claude Code是2.14亿;18号dsh 4.35亿,Claude Code 1.19亿。
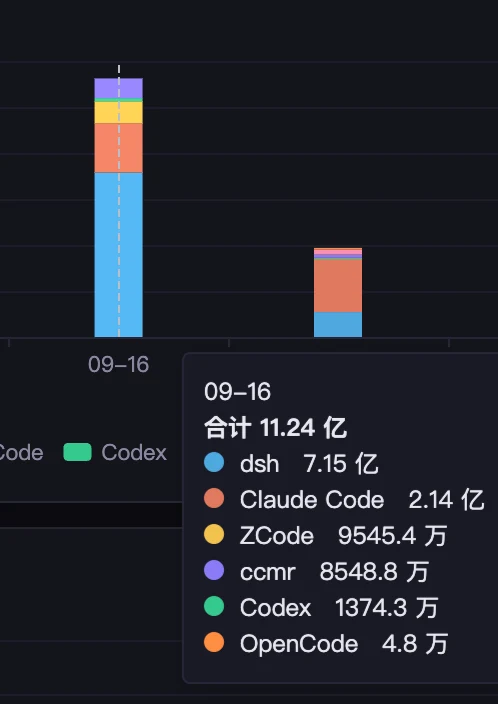
上周有三天我一共给dsh发了27条指令,它触发了7009次模型请求,平均一条指令260次左右;同一时间段Claude Code是196条指令、4576次请求,一条23次左右。两边做的任务不一样,dsh这边我又开了max推理和全权限,所以不是那种严格的1vs.1对比。有一点可以确定,dsh单次请求并不更重,平均每次带18.4万token的上下文,Claude Code是24.7万,多出来的消耗来自于请求次数。
请求次数分布大概是这样。最明显的是subagent扇出,比如有个项目我让它先做调研,结果这一调研就触发了2978次请求,其中2711次来自Subgent。再一个是上下文长期顶着不压缩。另外一个项目,主会话1786次请求平均每次带37.8万token,其中538次超过50万。还有goal自动续跑,同一个项目一个目标连跑了16轮。
dsh默认在上下文用到80%,也就是80万时自动压缩,但是每次请求还要给输出预留25.6万,而API上限是1048576,输入最多只能到79.2万,自动压缩那条线基本够不着。全部日志里只压缩过一次,还是撞上上限报错之后才触发的。按插件的设计,这是能自己动手改的:复制一份标准预设,给compaction-basic加上thresholdRatio: 0.7,阈值降到70万,压缩就能赶在溢出之前。
20亿token里99.4%是命中缓存的重复上下文,真正的新输入只有745万,输出523万。按DeepSeek官网现价和峰谷时段估算(这三天86%的用量落在高峰时段),3天用了300多块;如果一个都不命中,同样的量要大几千。
有一个医学影像浏览器的项目,dsh先启动了一个workflow(模型自己写一段编排脚本,一次扇出一批Subagent),四个Subagent分头调研现状差距、技术栈、PACS网络和许可合规,再派两个做对抗性核验,最后一个综合定稿,这一段用了34.4分钟,然后才问我那两道选择题,最后挂上goal去做技术验证。
另外一个家庭健康档案的项目,我之前先是让GLM-5.3-Flash做了初版,然后交给dsh优化。接手的时候我只提了一句"分别从功能和代码两个方向,全面review当前项目",它同时派出前端、后端、本地存储与iOS、产品四个评审Subagent,产品方面又往下指派了三个Subagents。评审完问了我两个问题,缺失的单位怎么处理、修复范围多大,然后挂上goal连续跑了16轮,接近3个小时才完成。
使用感受与期待
所以通过上周那几天的密集使用,整个感受下来就是快 + 费,任务完成质量倒也还行,虽然比不上Claude Fable和GPT Astra等前沿模型,但也够用了。
我倒是更期望官方能够正式发布dsh的Desktop和CLI版本,这两感觉更适合产品化推广。目前这个形态,就用户体验而言,比起Codex和WorkBuddy这种产品力拉满的Agent,dsh还啥差的老远。
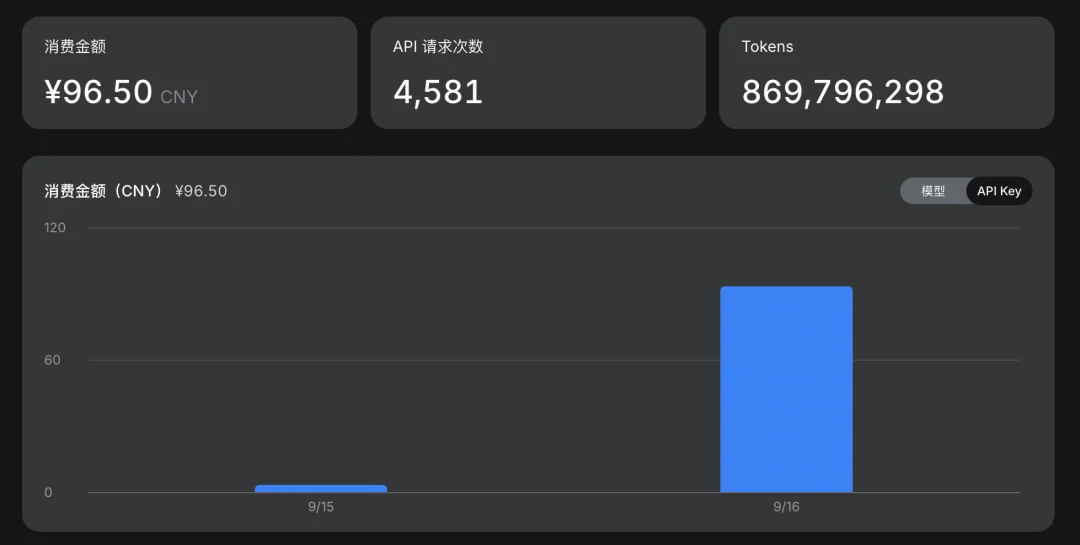
以及,最好DeepSeek能出个Coding Plan的订阅套餐,虽然目前API相对便宜,但也架不住一天百来块钱的花销啊。
本文首发于微信公众号「AI编程实验室」,阅读原文