大家好,我是鲁工。
最近Qwen3.8-27B这款模型火了,X上关于这款模型的好评不断。这款模型是阿里上周发布的 27.8B稠密多模态模型,文本、图像、视频都吃,原生256K上下文,Apache 2.0协议。它走的是小体量专注路线,主打编码和Agent能力,官方给的SWE-bench Pro是61.7分。
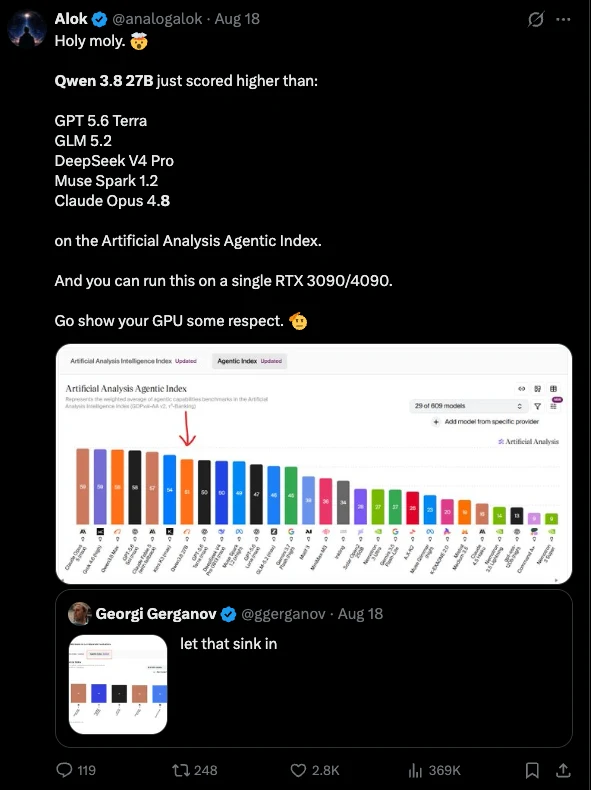
我看网上大家都在本地化部署这款27B的模型,这让我也来了兴趣。所以我今天就在尝试搭载两张4090显卡的服务器上部署了一把,主要方式是通过vLLM起成API服务,再通过我的ccmr接进了Claude Code。
硬件与环境
两张4090是改装后的涡轮版,显存有48G,两张卡就是96G,部署27B的模型正好适合:BF16权重约56GB,张量并行切到两张卡后每卡分摊28GB,剩下的显存全部留给KV缓存。模型可以从Hugging face或者ModelScope下载,总共18个safetensors模型分片,内网可以半小时内下载完。
环境上有个前置约束值得提一下。我的部署机器显卡驱动是560,对应CUDA上限12.6,而vLLM从 0.20起默认CUDA 13版本以上,所以只能用0.19.x。生产机器的驱动版本决定了整条软件栈的上限,先看nvidia-smi再选版本,提前避免版本问题。
启动 vLLM 服务
vllm模型服务启动命令:
vllm serve models/Qwen3.8-27B \
  --served-model-name qwen3.8-27b \
  --tensor-parallel-size 2 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.92 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_xml \
  --api-key <填写api-Key> --host 0.0.0.0 --port 8001
权重加载约7分钟,就绪后双卡各占45.2GB。单流解码20到30 tok/s,日常对话够用,但如果是生产环境干活的话,建议还是上专业卡部署为好。
工具调用与上下文配置
上面这条命令里有两个参数需要注意,容易造成一些小问题。
第一个参数上工具调用tool-call-parser。我一开始沿用了上次部署时的hermes解析器,结果一发带工具的请求,模型的回复正文里直接输出了一段裸文本。
工具调用没有被解析成结构化数据,而是当成普通文本作为输入。去翻模型自带的chat_template.jinja才发现,Qwen3.8用的是XML风格的函数调用格式,vLLM里对应的解析器叫 qwen3_xml,跟之前hermes那套JSON格式完全不同。换掉之后,返回里才有了正经的tool_use块。这个问题可能普通对话感觉不到,但对于用Claude Code是致命的,它的一切操作都靠工具调用,解析器配错等于整个Agent瘫痪。
第二个问题是上下文长度。我起初设了128K,想着先初步测一下,发现上下文太短以至于没法做任务测试。然后就想着直接拉满原生256K,但又碰到另一个问题:BF16精度下两张卡的KV cache池实测只装得下13.3万token,256K的单条请求物理上放不下。最后的方案是加一个--kv-cache-dtype fp8,把KV cache转成FP8精度(4090的Ada架构原生支持),容量翻倍到26.8万token,这才能使得上下文开到256K。代价是KV从16位降到8位,超长上下文的召回质量有没有折损,还得再观察一段时间。所以大模型本地化部署这个事情,有条件能上大显存的专业卡,尽量上专业卡。
通过 ccmr 接入 Claude Code
vllm服务起好之后,就是把服务接入到Claude Code。ccmr是我之前做的一个轻量级的Claude Code第三方模型路由网关,原理和双模式隔离在这篇写过:ccmr已接入Kimi K3,Claude Code开跑2.8T开源旗舰模型,之前接的都是DeepSeek、Kimi、GLM、Qwen这些云端旗舰模型。这次是头一回往里接自己机器上的模型。
仓库地址:
https://github.com/luwill/Claude-Code-Model-Router
能不能接,取决于一个点:ccmr是Anthropic协议直通网关,不做OpenAI协议翻译,所以上游必须原生支持Anthropic的/v1/messages端点。而vLLM现在是自带这个端点的,流式、count_tokens、thinking块都有,等于开箱就是一个Anthropic兼容服务。配置就几行:
qwen-local:
  base_url: http://<内网IP>:8001
  api_key_env: QWEN_LOCAL_API_KEY
  auth_header: Authorization  # vLLM 只认 Bearer,不认 x-api-key
  auth_type: bearer
  variants:
    27b:
      model_id: qwen3.8-27b
      max_tokens: 32768
      context_window: 262144
配置好直接启动使用Qwen3.8-27B模型启动ccmr即可:
ccmr claude --model qwen-local-27b
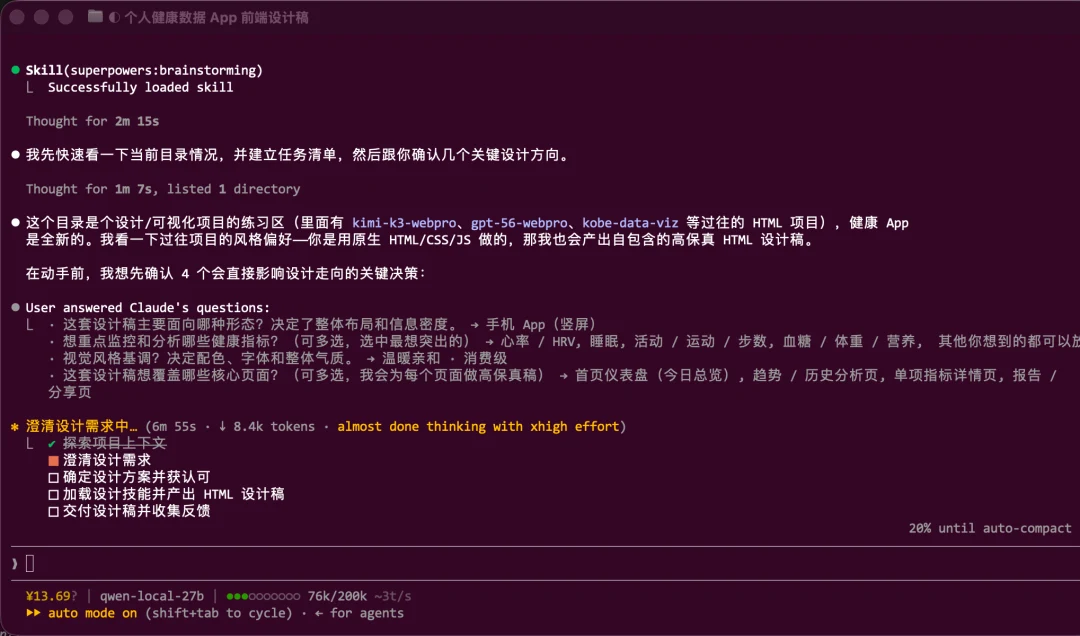
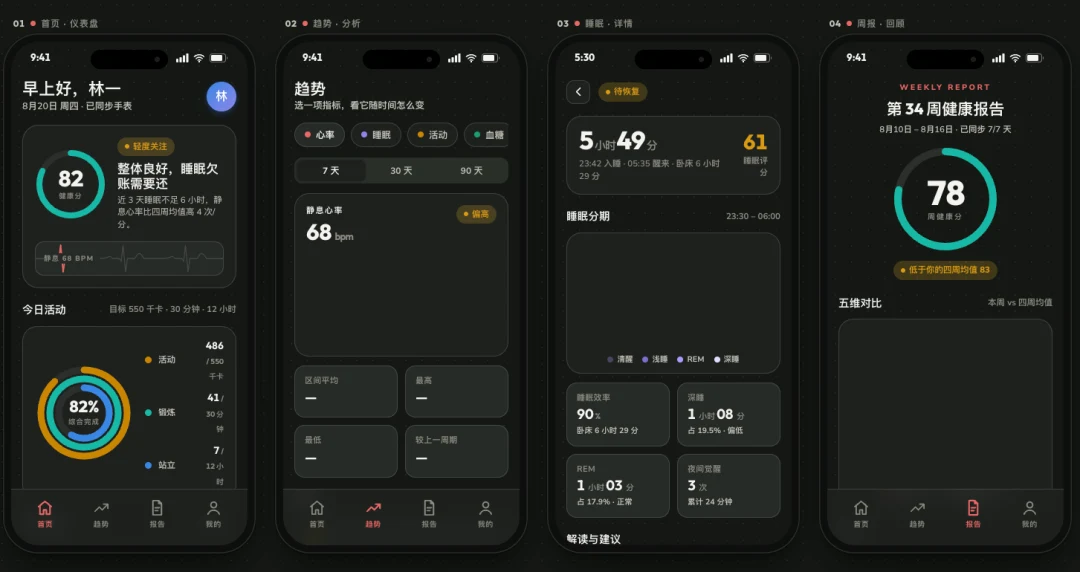
实测让Claude Code + Qwen3.8-27B做一个个人健康管理APP前端设计,效果还不错,但因为实在太慢了,我没耐心等它做完就停掉了。所以在消费卡上这么玩肯定没办法干活。
这两天,X上对这个模型评价很高。第三方基准Artificial Analysis给了52分,社区也认为这个分数跟体量大得多的GLM 5.2、GPT 5.6 Luna同档,跟总参284B的DeepSeek Flash 0731分数一样,在Qwen模型序列里排第二,只输给旗舰Qwen3.8 Max。官方口径的SWE-bench Pro 61.7对比Claude Opus 4.6 Max的53.4,但作为不同harness下跑出来的分数,作为参考就好。
并且社区最近还有各种量化版、uncensored版本等,甚至一些极致量化版本在16G的Mac上就能跑。
使用体验与适用场景
社区反馈Qwen3.8-27B最大的问题是:完成同一个任务,它的输出token大约是上代Qwen3.6的2倍。这一点其实对不是用专业卡部署来说,单流20到30 tok/s的本地速度,再遇上一个话痨模型,思考块经常刷得比答案还长,慢得急死人,并且很容易思考的太多,但实际干活太少。另一条有意思的观察是它在世界知识评测上比3.6还略降了一点,等于用知识储备换了编码和Agent能力,但非幻觉评分很高,不知道的事它知道自己不知道,配上工具调用刚好补齐。
大模型本地化部署的价值不在于替代订阅,而在那些数据出不了内网的行业和场景,代码和对话全程留在自己机器上,Apache 2.0协议商用也没有障碍,以及无限token的爽感。有本地化部署需求的值得一试,但对于大多数用户而言,还是老老实实买各大模型厂商的订阅就好。
本文首发于微信公众号「AI编程实验室」,阅读原文